NetSendo v2.7.0: semantyczny Brain i edytor tekstu sformatowanego
Asystent AI jest tak dobry, jak kontekst, który otrzymuje. Jeśli przez miesiące uzupełniałeś Brain w NetSendo o opisy produktów, case studies, odpowiedzi na obiekcje i notatki z kampanii, mogłeś trafić na frustrujące ograniczenie. Do tej pory Brain dodawał do każdego promptu pięć najwyżej ocenionych wpisów z kilku stałych kategorii, niezależnie od tego, czego dotyczyło zadanie. W dużej bazie wiedzy większość tego, co Brain wiedział, nigdy do niego nie docierała.
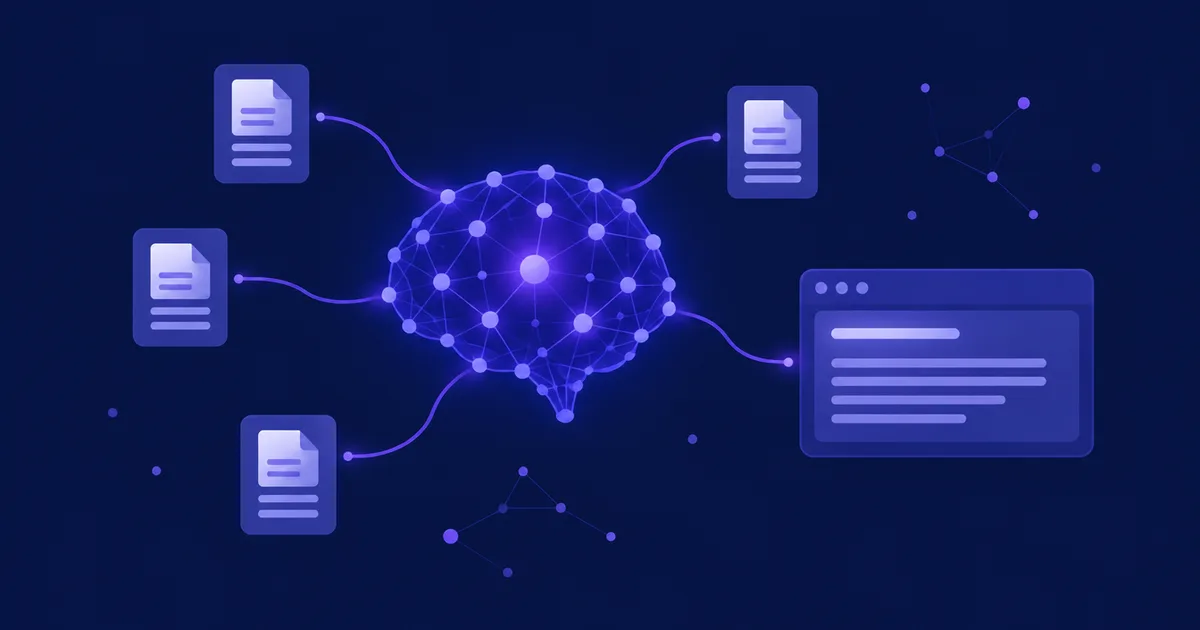
NetSendo v2.7.0 rozwiązuje ten problem dzięki semantycznemu wyszukiwaniu wiedzy w planie GOLD. Brain szuka teraz wiedzy, która znaczeniowo pasuje do danego zadania. Wersja dodaje też prawdziwy edytor tekstu sformatowanego w kreatorze szablonów e-mail i sprawia, że instalacje oraz aktualizacje w Dockerze są bezpieczniejsze.
docker compose pull && docker compose up -d.
🚀 Co nowego w v2.7.0
Semantyczna baza wiedzy Brain (GOLD)
Wyszukiwanie według kategorii działa jak bibliotekarz, który za każdym razem podaje pięć najpopularniejszych książek z tej samej półki, niezależnie od pytania. Wyszukiwanie semantyczne działa jak bibliotekarz, który najpierw czyta pytanie, a potem wybiera właściwe strony z całej biblioteki.
Jak to działa:
- Dzielenie na fragmenty: każdy wpis jest dzielony na fragmenty po około 1200 znaków.
- Embeddingi: każdy fragment zamienia się w wektor, czyli listę liczb, która odzwierciedla jego znaczenie.
- Dopasowanie: każde zadanie jest porównywane z fragmentami według znaczenia. Zadaniem może być wiadomość na czacie, temat e-maila lub kampanii, cel, brief playbooka albo zadanie cron.
- Premie: fragment dostaje niewielką premię, jeśli zawiera słowa znalezione przez indeks pełnotekstowy, należy do kategorii zadania albo pochodzi ze zweryfikowanego wpisu. Dopasowania znacznie słabsze od najlepszego są pomijane.
Wpisy o głosie marki i firmie nadal trafiają do zadań pisarskich. Wpis może mieć teraz do 100 000 znaków w planie GOLD i do 10 000 w planie SILVER.
Kontekst według znaczenia
Brain dostaje wiedzę pasującą do bieżącego zadania, a nie stały zestaw wpisów.
Twój własny dostawca
OpenAI, Gemini, OpenRouter lub lokalny model Ollama (bge-m3).
Bez nowej usługi
Wektory są zapisywane w MySQL jako spakowane float32. Przeszukanie 5000 fragmentów zajmuje około 60 ms.
Automatyczny tryb awaryjny
Jeśli dostawca embeddingów nie odpowiada, Brain czyta bazę wiedzy według kategorii, tak jak wcześniej.
ℹ️ Dlaczego bez bazy wektorowej? TypVECTORw MySQL 9 nie ma funkcji odległości poza HeatWave, a MySQL Community nie potrafi przeszukiwać wektorów. Dlatego NetSendo zapisuje wektory (768 wymiarów, jeśli model pozwala je skrócić) w nowej tabeliknowledge_chunksi porównuje je w PHP. Nie musisz dodawać Qdranta, pgvectora ani żadnego innego kontenera.
Indeks aktualizuje się sam. Gdy dodasz lub zmienisz wpis, zadanie IndexKnowledgeEntry w kolejce tworzy dla niego embeddingi, a zmieniony tekst usuwa swoje stare wektory. Co godzinę polecenie brain:index-knowledge uzupełnia wszystko, czego jeszcze brakuje. Zapis wpisu nigdy nie kończy się błędem z powodu niedostępnego dostawcy. Jeśli zmienisz model, cała baza wiedzy zostanie ponownie zindeksowana w tle, a wektory z różnych modeli nigdy się nie mieszają. Endpoint API GET /api/v1/brain/knowledge?search= w planie GOLD również szuka według znaczenia.
Edytor tekstu sformatowanego w blokach szablonów
Przed tą wersją pole bloku tekstowego było zwykłym polem tekstowym. Jeśli zmieniłeś jedno słowo w treści wygenerowanej przez AI, blok tracił linki, pogrubienia, nagłówki i kolory. Teraz to edytor TipTap z pogrubieniem, kursywą, podkreśleniem, linkami, listami, łamaniem wiersza (Shift+Enter) oraz cofaniem i ponawianiem zmian.
- Bezpieczny co do bajtu: nic nie jest zapisywane, dopóki nie zmienisz tekstu. Style inline, takie jak
#64748bi właściwościmso-*, pozostają dokładnie takie, jak zostały zapisane. - Wstawianie zmiennej w miejscu kursora: zmienne, fragmenty treści i podpisy trafiają tam, gdzie jest kursor, a nie na koniec tekstu.
- HTML bezpieczny dla e-maili: skrypty, iframe'y, formularze, znaczniki
<font>i klasy CSS są usuwane, a linkijavascript:są odrzucane. Placeholdery takie jak[[unsubscribe]]działają jako adresy linków. Elementy list są zapisywane bez wewnętrznych znaczników<p>, więc klienty poczty nie dodają zbędnych marginesów.
Bazę danych migruje tylko jeden kontener
Kontenery app, scheduler, queue i reverb korzystają z tego samego entrypointu. Przed tą wersją wszystkie cztery mogły uruchamiać migracje jednocześnie, co powodowało błędy takie jak Table 'users' already exists i mogło zostawić migrację wykonaną tylko częściowo. Migracje i seedowanie działają teraz pod blokadą nazwaną MySQL (GET_LOCK). Jeden kontener przygotowuje bazę danych, a pozostałe czekają. Jeśli ten kontener padnie, MySQL automatycznie zwolni blokadę.
💼 Korzyści i przypadki użycia
E-commerce: kampanie, które znają produkty
Zapisz w Brain pełne karty produktów, zasady zwrotów i promocje sezonowe. Gdy poprosisz Brain o e-mail o porzuconym koszyku z kurtkami zimowymi, użyje specyfikacji kurtek i zasad darmowych zwrotów zamiast niezwiązanych ogólników o firmie.
SaaS: onboarding i zapobieganie rezygnacjom
Wgraj do Brain obszerną dokumentację, do 100 000 znaków na wpis. Sekwencje onboardingowe i kampanie win-back mogą wtedy odnosić się do konkretnych funkcji, z którymi użytkownik ma problem, a asystent na czacie odpowie na szczegółowe pytania o produkt.
Agencje: prywatne AI z Ollamą
Pracujesz z danymi klientów, które nigdy nie powinny opuścić Twoich serwerów? Użyj lokalnego modelu Ollama (bge-m3) do tworzenia embeddingów. Cały proces wyszukiwania działa wtedy na Twojej infrastrukturze, co jest mocnym argumentem za self-hostingiem.
🛠️ Przewodnik krok po kroku
- Zrób kopię zapasową bazy danych
Ta wersja zawiera trzy migracje: tabelę
knowledge_chunks, dwie nowe kolumny wai_brain_settingsoraz zmianę typuknowledge_entries.contentnaMEDIUMTEXT. - Zaktualizuj obraz
docker compose pull && docker compose up -dNowy obraz już chroni polecenia
migrateidb:seedblokadą w bazie danych. - Zaktualizuj plik compose i entrypoint (zalecane)
Twoja instalacja montuje własną kopię entrypointu, więc pobranie obrazu jej nie zastąpi. Uruchom
git pullalbo pobierzdocker-compose.ymlidocker/php/docker-entrypoint.shz wydania v2.7.0. Z oboma plikami bazę migruje tylkoapp, a pozostałe kontenery startują, gdy skończy. - Skonfiguruj wyszukiwanie semantyczne
Przejdź do Brain → Ustawienia → Baza wiedzy → Wyszukiwanie semantyczne. Wybierz integrację i model albo zostaw ustawienie automatyczne. NetSendo sprawdza model przed zapisaniem i pokazuje, ile wpisów jest zindeksowanych.
- Zindeksuj istniejące wpisy
Cogodzinne zadanie zindeksuje istniejące wpisy, ale możesz zacząć indeksowanie od razu:
docker compose exec app php artisan brain:index-knowledge --sync
⚠️ Częsty błąd: Anthropic i Grok nie mają endpointu do embeddingów. Jeśli to Twoje jedyne integracje AI, najpierw dodaj integrację OpenAI, Gemini, OpenRouter lub Ollama w Ustawienia → Integracje AI. Zobacz Integracje.
🎯 Porady ekspertów
Fragmenty mają około 1200 znaków. Wyraźne nagłówki i jeden temat na sekcję dają trafniejsze dopasowania.
Zweryfikowane wpisy dostają premię w rankingu, więc oznacz swoje najbardziej wiarygodne źródła jako zweryfikowane.
Nowy model indeksuje ponownie całą bazę wiedzy. Przy dużych bazach zmieniaj model poza godzinami szczytu.
Przy długich migracjach na dużych bazach ustaw NETSENDO_MIGRATIONS_WAIT_TIMEOUT. Domyślna wartość to 1800 sekund.
🔧 Inne poprawki i usprawnienia
- Skrypt
install.shtworzy teraz działającą instalację. Pobiera wszystkie pliki montowane przez plik compose, generujeAPP_KEYi losowe hasło do bazy danych, nie nadpisuje istniejącego pliku.envi czeka, aż aplikacja zacznie odpowiadać. - Klawisz Delete nie usuwa już całego zaznaczonego bloku podczas pisania w polu tekstowym kreatora szablonów.
- Kliknięcie w blok tekstowy nie usuwa już jego formatowania.
- Wpisy z web research znów trafiają do Brain. Wpisy z kategoriami wymyślonymi przez AI trafiają teraz do Insights, a dawna kategoria zostaje zachowana jako tag.
- Nowe wpisy bazy wiedzy zaczynają teraz z kategorią Firma, więc zapis bez wybrania kategorii nie kończy się już cichym błędem.
- Integracja Ollama za proxy wysyła teraz opcjonalny klucz API jako token bearer.
- Tytuły wydań z metadanymi buildu wyświetlają się poprawnie, a HTML jest zamieniany na tekst parserem przeglądarki zamiast wyrażenia regularnego.
- Dokumenty README, DOCKER_INSTALL, CONTRIBUTING i SECURITY zostały zaktualizowane, a nieaktywne linki do
forum.netsendo.comusunięte.
🎉 Podsumowanie
W wersji v2.7.0 Brain w NetSendo wyszukuje wiedzę według znaczenia, a wszystko działa na Twoim własnym MySQL z wybranym przez Ciebie dostawcą AI. Edycja szablonów zachowuje formatowanie, a aktualizacje w Dockerze są bardziej niezawodne. Twoje dane pozostają Twoją własnością i nie zależysz od jednego dostawcy.
Gotowy na aktualizację?
Zaktualizuj NetSendo do v2.7.0, aby zacząć korzystać z semantycznego wyszukiwania wiedzy.
Jeśli podoba Ci się NetSendo, daj nam gwiazdkę na GitHubie.